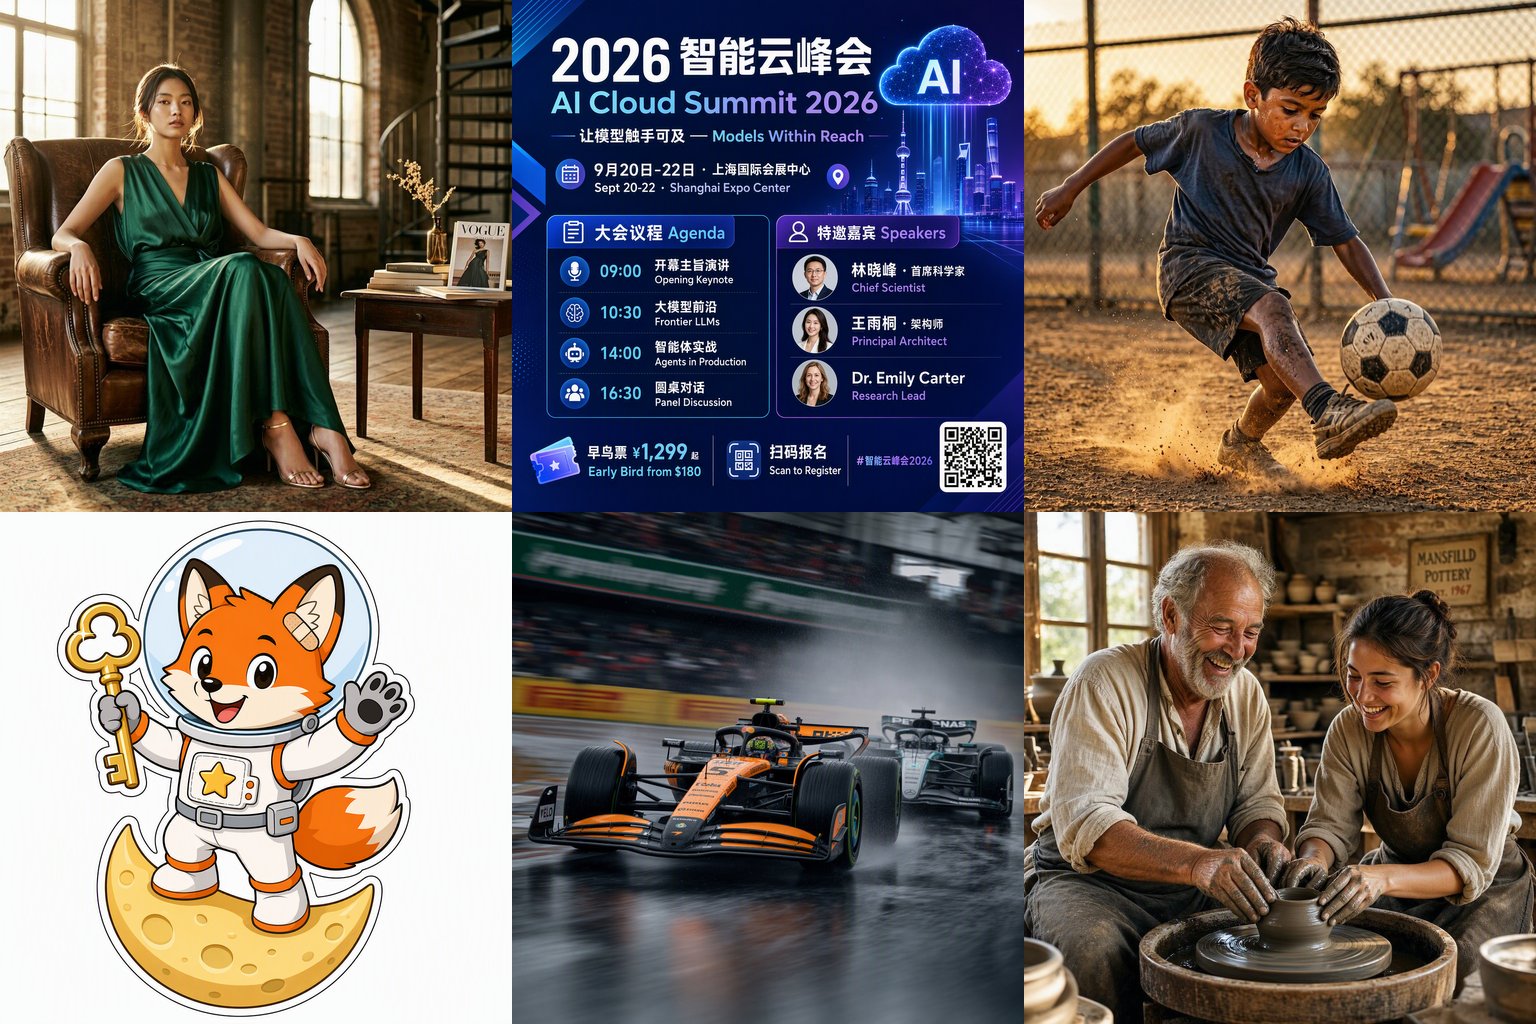
MAI-Image-2.5 vs GPT-Image-2:微软自研生图追上 OpenAI 了吗?
微软自研的 MAI-Image-2.5 系列(2.5 / Flash / Pro,均为 Preview)与 OpenAI 的 GPT-Image-2(medium / high 两档,GA),在 Azure AI Foundry 上用同一组 10 场景 prompt 各生成一次,共 50 次请求、46 张成功出图。答案不在「谁的画质更好」:文字归 GPT,人像归 MAI——中间隔着一次内容过滤拦截和十倍的出图时间差。
🔬 假设 (Hypothesis)
MAI-Image-2.5 系列的生图质量已足以在生产环境替代 GPT-Image-2 作为默认生图模型。
判据:同 prompt 实测 10 场景中,MAI 至少半数场景不劣于 GPT-Image-2 medium,且不存在「某整类需求不可用」的硬缺陷。满足两者则假设成立;任一不满足则按场景分化。
0. 先厘清三个容易被误传的说法
本研究不附和厂商话术,也纠正我们自己内部速报里的不严谨表述:
- 「MAI-Image-2.5 是 Arena 第二名」 — 口径混乱。微软发布公告写「No. 2」,自家 Foundry Labs 模型页写「debuting at #3(+74.5 ELO)」,官方博客又称「超过 Nano Banana Pro 的 Arena 分数」,第三方拆分口径为文生图 No.3 / 图编辑 No.2。同一厂商的三个页面给出两种名次——本研究不采信任何榜单名次作为结论依据,只使用自己的同题实测。primary 核实(冲突已记录)
- 「GPT-Image-2 只支持固定三档分辨率」 — 不实(本课题的内部速报也曾如此记载,在此更正)。官方文档明确:GPT-Image-2 支持任意分辨率至 4K(各边 16 px 倍数,总像素 655,360–8,294,400)。反而是 MAI 系总像素上限约 1024×1024(各边最小 768)。分辨率自由度上 GPT 更强,不是更弱。primary 核实
- 「MAI Flash 每图 $0.027」 — 说满了。Flash 图像输出牌价存在 $26/M 与 $33/M 两种口径(后者出自对官方公告的转述,且注明有 $19.50–$33 区间),每图成本应表述为 $0.027–$0.034 区间,而非单点。secondary 冲突已标注
1. 实验设计(可复现)
| 项 | 设置 |
|---|---|
| 平台 | Azure AI Foundry(MAI 走专有 /mai/v1/images/generations,GPT 走 OpenAI images API,api-version 2025-04-01-preview) |
| 被测模型 | MAI-Image-2.5(2026-06-02)/ 2.5-Flash(2026-06-02)/ 2.5-Pro(2026-06-19),均 Preview、GlobalStandard、12 RPM 满配额;GPT-Image-2(2026-04-21,GA)medium 与 high 两档 |
| 规格 | 统一 1024×1024,每题每档生成 1 次,不重试、不挑选,全部原始输出 |
| 场景 | 10 组:简单主体 / 英文海报 / 复杂多对象 / 双人人像 / 真人写真 / 卡通细节指令 / F1 高速运动 / 中英高密度海报 / 四格漫画 / 儿童运动 |
| 产出 | 50 格 = 46 张成功 + 4 个请求返回 HTTP 400(详见场景 05 / 10) |
| 台账 | 逐请求延迟、token 用量、错误码记录于 results.json(脱敏公开);生成脚本幂等,跳过已成功格子 |
质量裁决(最佳 / 达标 / 有偏离)为人工逐格核对 prompt 要求(文字逐字、指令逐项)。文字错字这类客观可数缺陷是本研究最强的证据;画质观感类判断的主观性在「对抗验证」中如实交代。页面附图均为实测原始输出的降采样副本,未经任何修饰;点击图片可查看大图。
2. 总览:速度、价格与结论
先看三件决定选型的事:出图要等多久,每张多少钱,以及已经能下的判断。
出图延迟
Flash 中位 15.8 秒,GPT-Image-2 high 中位 158.3 秒——两端正好十倍。
每图成本 @1024×1024
每图 token 数取自本次实测的 API usage 字段(一手);MAI 恒定 1,024 tokens/图,GPT medium/high 分别为 1,756/7,024——四倍 token 差直接构成四倍价差。
token 单价明细(美元 / 1M tokens)
| 模型 | 文本入 | 图入 | 图出 | 每图 token |
|---|---|---|---|---|
| MAI-Image-2.5 | $5 | $8 | $47 | 1,024(恒定) |
| MAI-Image-2.5-Flash | $1.75–5* | $1.75–8* | $26–33* | 1,024(恒定) |
| MAI-Image-2.5-Pro | $5 | $8 | $106 | 1,024(恒定) |
| GPT-Image-2 (medium) | $5 | $8 | $30 | 1,756(实测) |
| GPT-Image-2 (high) | $5 | $8 | $30 | 7,024(实测) |
文字与细节指令:GPT-Image-2 明显占优
英文海报、细节方位、中文高密度海报、四格漫画四场全胜。中文尤其拉开差距——GPT 近乎零错字,MAI 三款版面结构对但都有字形级错字。海报、漫画、任何带文字的需求直接选 GPT。
人像与真人摄影:默认过滤下 MAI 是唯一可用选项
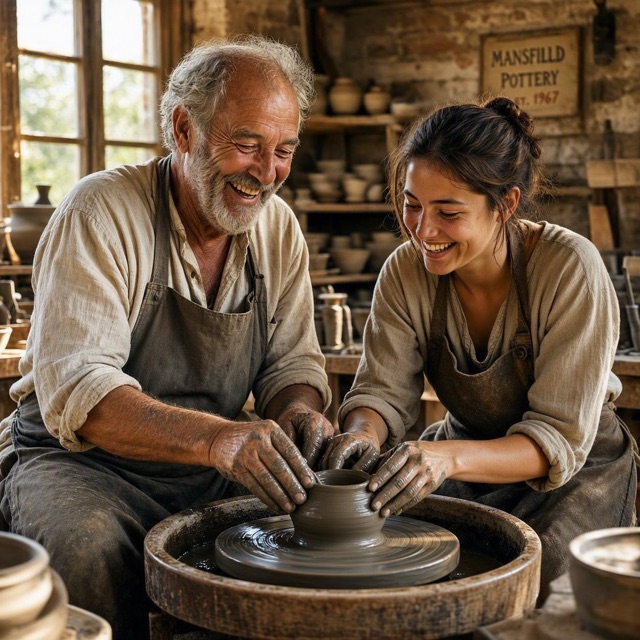
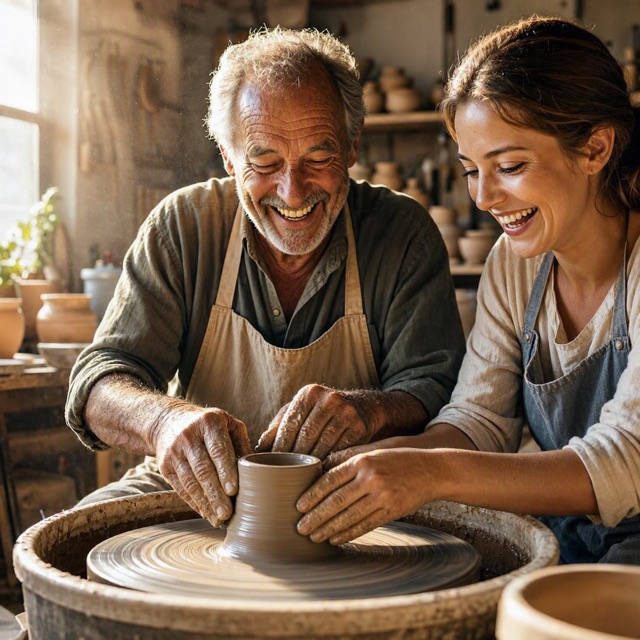
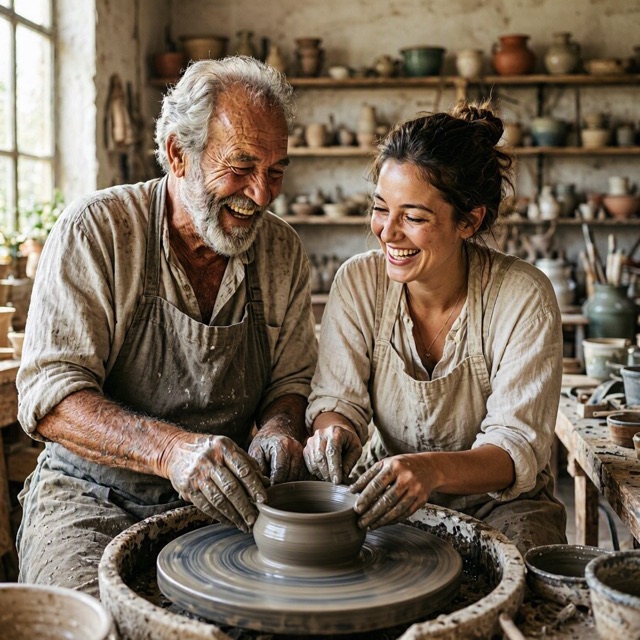
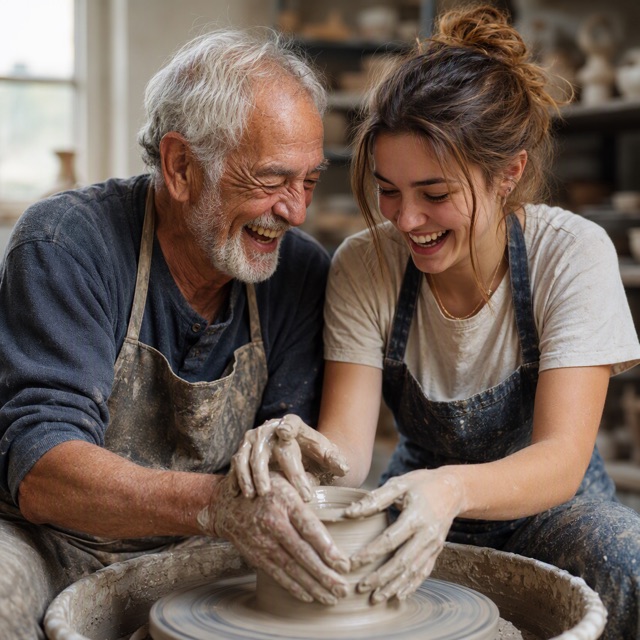
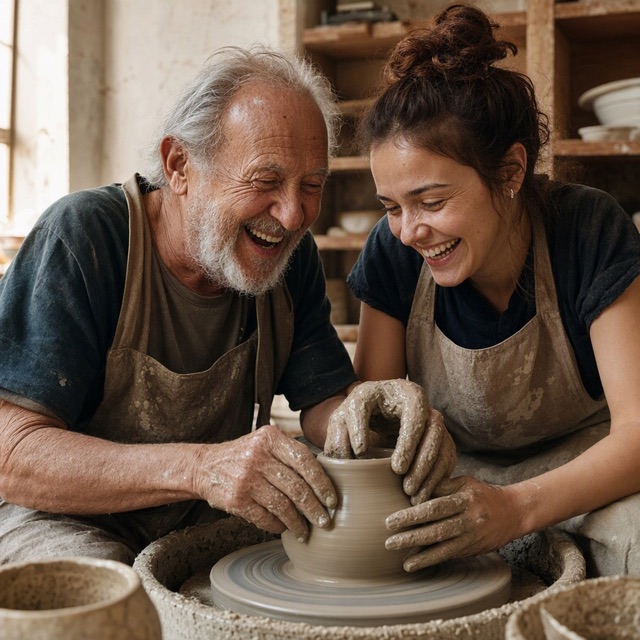
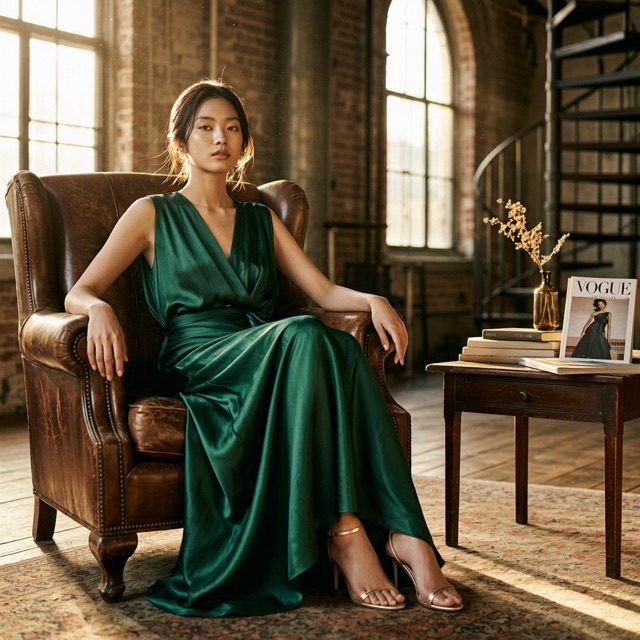
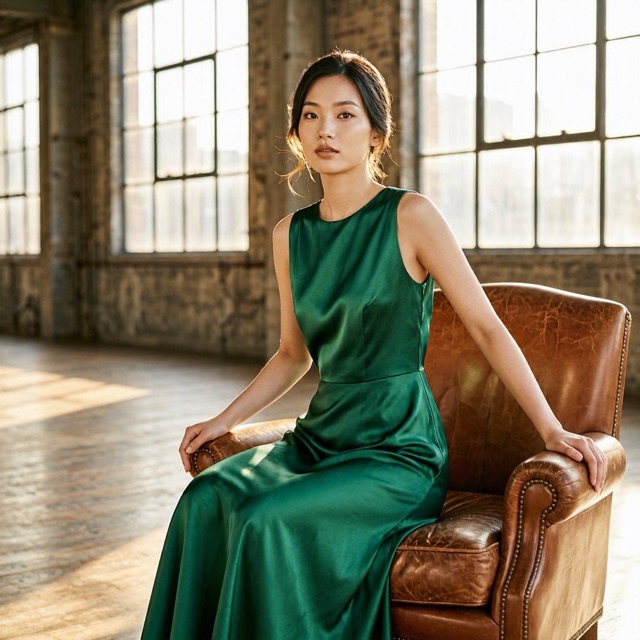
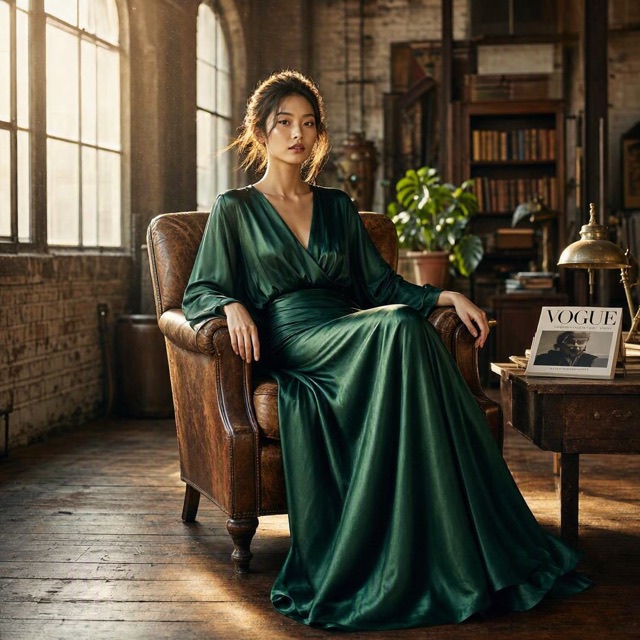
双人陶艺题四手同框 MAI 三款全过、GPT medium 手部交缠;真人写真与儿童运动两题,GPT 两档请求均被内容过滤拦截(HTTP 400)。注意边界:Azure OpenAI 过滤阈值可配置(全关需审批),本结论仅在默认配置下成立。
速度:两端相差十倍
Flash 中位 15.8 秒,是 GPT high(158.3 秒)的十分之一。GPT 的高延迟与其思考/路由层设计一致,是档位特性而非故障——但对交互式场景就是硬约束。
成本:同档基本持平,档位选择才是变量
MAI-2.5 每图约 $0.048 ≈ GPT medium($0.053),为 GPT high($0.211)的约四分之一。未测质量的 GPT low 档仅 $0.006/图——若其质量满足业务底线,成本结论将反转。
版权倾向:MAI 画虚构品牌,GPT 画真实涂装
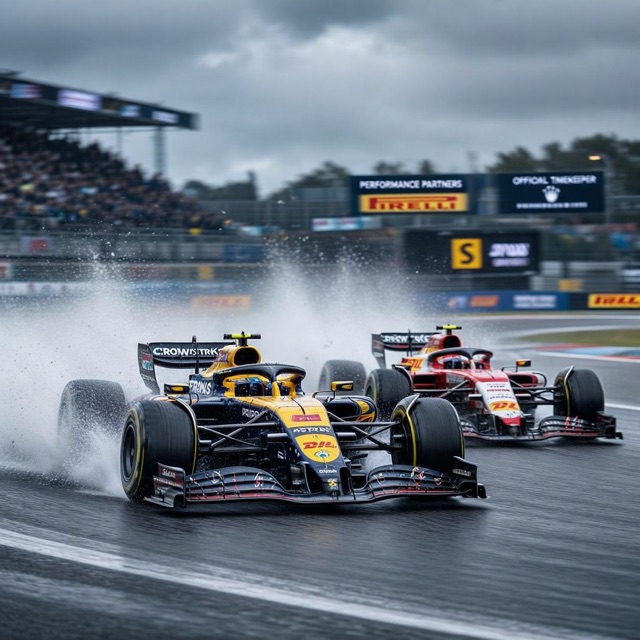
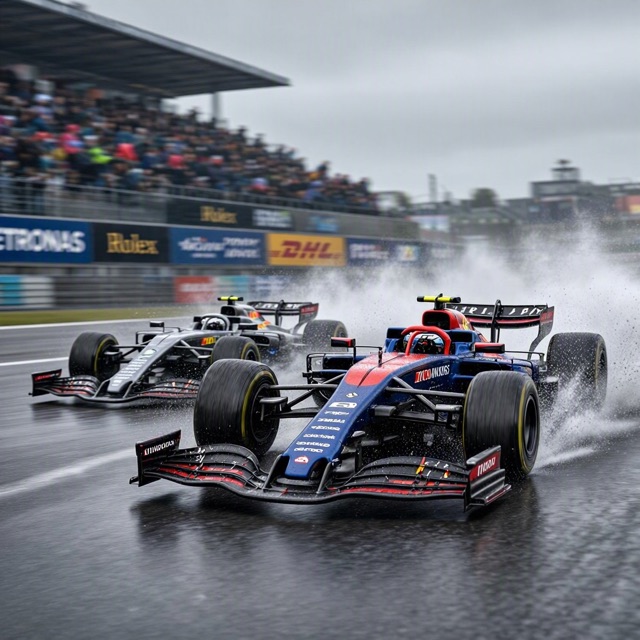
F1 题 GPT 两档直接画出真实车队涂装,MAI 倾向虚构品牌。商用素材合规角度 MAI 更稳,但这是单场景观察(n=1),不能外推为系统性策略差异。
3. 价格与能力对比
同样是 Azure 上的生图模型,两家在分辨率自由度、协议、编辑能力和内容策略上是不同的产品形态——这些差异往往比画质更早决定选型。均为官方文档口径(2026-08-05 核实),并已修正内部速报中的两处失实。
输出规格
| MAI-Image-2.5微软 | MAI-Image-2.5-Flash微软 | MAI-Image-2.5-Pro微软 | GPT-Image-2 (medium)OpenAI | GPT-Image-2 (high)OpenAI | |
|---|---|---|---|---|---|
| 分辨率 | 自由 width×height各边 ≥768,总像素 ≤1,048,576(约 1024² 封顶) | 自由 width×height各边 ≥768,总像素 ≤1,048,576(约 1024² 封顶) | 自由 width×height各边 ≥768,总像素 ≤1,048,576(约 1024² 封顶) | 任意分辨率至 4K各边 16px 倍数,总像素 655,360–8,294,400(官方文档) | 任意分辨率至 4K同左;本次测试统一 1024×1024 |
| 清晰度档位 | 单一档无 quality 参数 | 单一档无 quality 参数 | 单一档无 quality 参数 | low / medium / high本次测 medium | low / medium / high本次测 high |
| 输出格式 | PNG (b64)恒定 | PNG (b64)恒定 | PNG (b64)恒定 | PNG (b64)可选格式参数 | PNG (b64)可选格式参数 |
| 单次出图数 | 1 张无 n 参数 | 1 张无 n 参数 | 1 张无 n 参数 | n 张支持批量 | n 张支持批量 |
接口与能力
| MAI-Image-2.5微软 | MAI-Image-2.5-Flash微软 | MAI-Image-2.5-Pro微软 | GPT-Image-2 (medium)OpenAI | GPT-Image-2 (high)OpenAI | |
|---|---|---|---|---|---|
| 协议 | 专有 /mai/v1非 OpenAI 兼容, 需单独适配 | 专有 /mai/v1非 OpenAI 兼容, 需单独适配 | 专有 /mai/v1非 OpenAI 兼容, 需单独适配 | OpenAI images 兼容现有 SDK 直接可用 | OpenAI images 兼容现有 SDK 直接可用 |
| 编辑能力 | 文生图 + 图生图multipart edits API | 文生图 + 图生图multipart edits API | 文生图 + 图生图multipart edits API | 编辑 + mask 局部重绘支持 inpaint | 编辑 + mask 局部重绘支持 inpaint |
| prompt 上限 | 32K tokens | 32K tokens | 32K tokens | 按 images API 限制 | 按 images API 限制 |
| 内容安全策略 | 人像题全放行真人写真 / 儿童运动两题均正常出图 | 人像题全放行真人写真 / 儿童运动两题均正常出图 | 人像题全放行真人写真 / 儿童运动两题均正常出图 | 人像题全被拦真人写真/儿童运动两题在默认过滤配置下被拦截(HTTP 400) | 人像题全被拦真人写真/儿童运动两题在默认过滤配置下被拦截(HTTP 400) |
| 审核强度可调 | 文档未提供配置面官方建议自行叠加内容安全治理 | 文档未提供配置面同左 | 文档未提供配置面同左 | 阈值可配置低/中/高三档可调;完全关闭需 Limited Access 审批 | 阈值可配置同左;本次实测为默认配置 |
价格与配额
| MAI-Image-2.5微软 | MAI-Image-2.5-Flash微软 | MAI-Image-2.5-Pro微软 | GPT-Image-2 (medium)OpenAI | GPT-Image-2 (high)OpenAI | |
|---|---|---|---|---|---|
| token 单价 / 1M | $5 / $8 / $47文本入 / 图入 / 图出 | 牌价口径分歧$5/$8/$26(内部速报)vs $1.75/$1.75/$33(官方公告转述) | $5 / $8 / $106最高质量档, 图出为 2.5 的 2.3 倍 | $5 / $8 / $30Batch 半价, 缓存输入 $2/M | $5 / $8 / $30Batch 半价, 缓存输入 $2/M |
| 每图成本 | ≈$0.05恒定, 不随尺寸跳变 | ≈$0.027全场最低价 (GPT low 除外) | ≈$0.109约为 2.5 的 2.3 倍 | ≈$0.053@1024²; low 档仅 $0.006 | ≈$0.211@1024²; 约为 medium 四倍 |
| 调用频率上限 | 每分钟 12 次GlobalStandard 配额顶格(官方分 6 档,2.5 系最高 12 RPM/订阅/区) | 每分钟 12 次GlobalStandard 配额顶格(官方分 6 档,2.5 系最高 12 RPM/订阅/区) | 每分钟 12 次GlobalStandard 配额顶格(官方分 6 档,2.5 系最高 12 RPM/订阅/区) | 每分钟 12 次本次测试环境 | 每分钟 12 次本次测试环境 |
MAI-Image-2.5 三款为 Preview(无 SLA,仅 7 个 region),定价为 2026-08-05 核实口径;表中每图成本按 1024×1024 计。矩阵复述:分辨率自由度、协议兼容性、批量与 mask 编辑、生产成熟度 GPT 占优;人像可用性(默认过滤下)与延迟 MAI 占优;同档成本基本持平。
4. 十组场景,逐张对照
同一条 prompt 同时发给五个档位,1024×1024 单次生成不重试。每格标注实测延迟与裁决(最佳 / 达标 / 有偏离 / 未出图),点击图片查看大图。
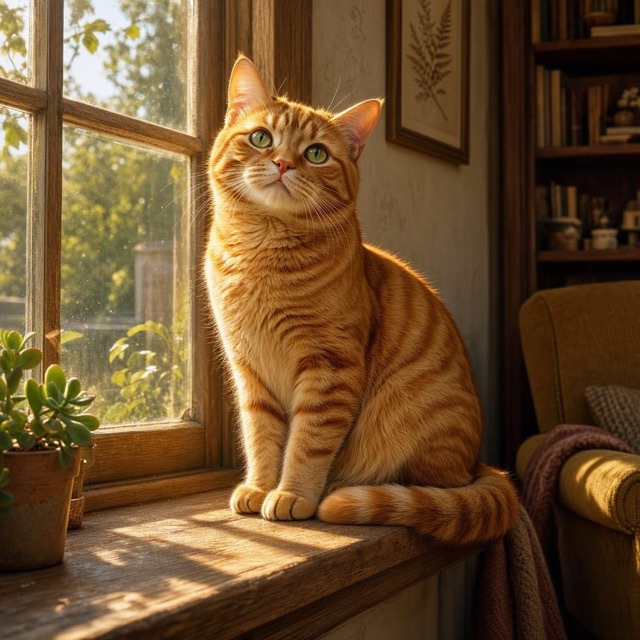
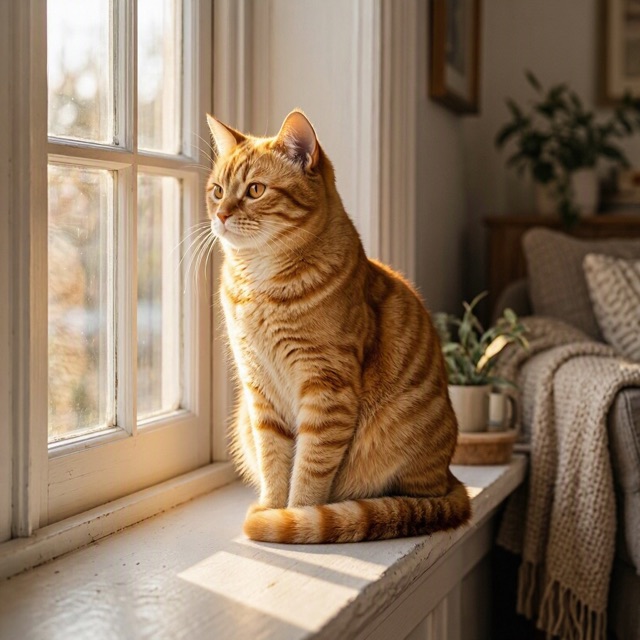
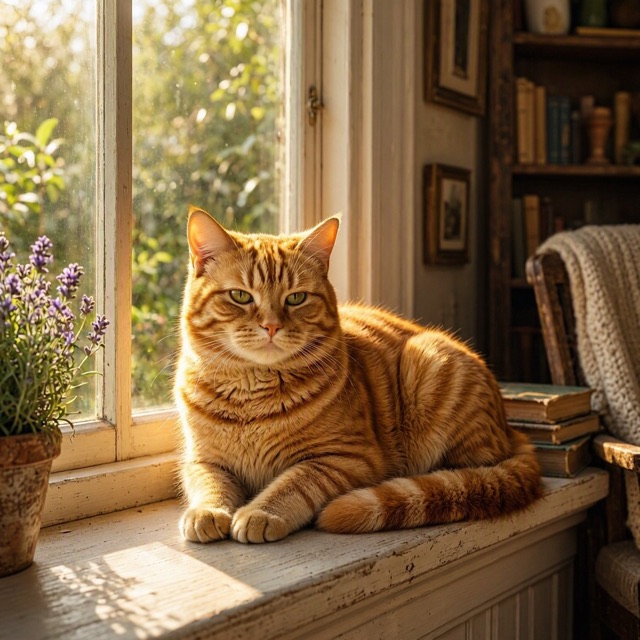
简单场景 · 橘猫窗台
基础质感与光影 — 单主体、无文字、无复杂指令时的底子如何。
查看原始 prompt
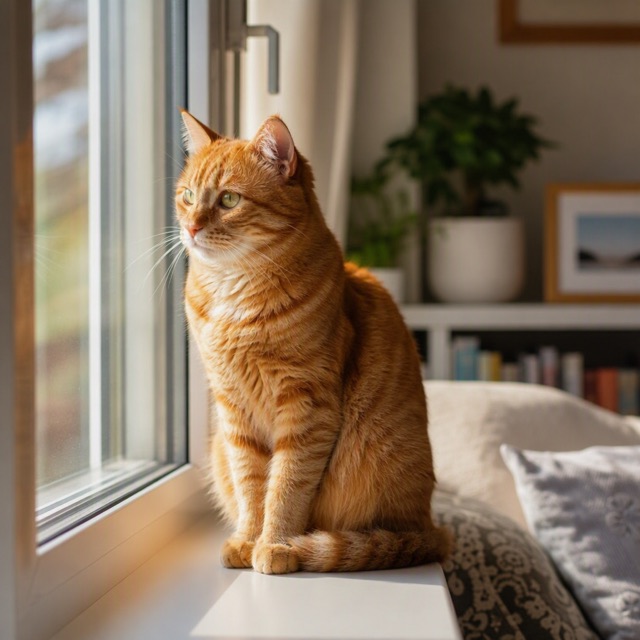
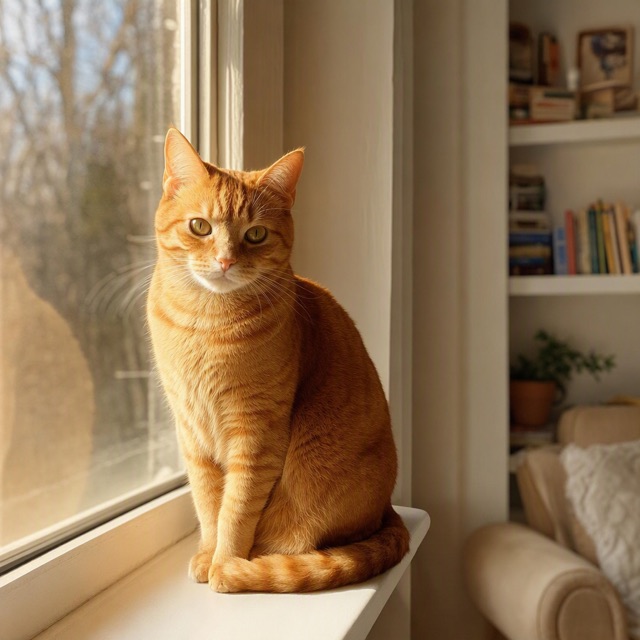
窄屏下左右滑动查看五个档位
产品海报 · 英文文字
短英文文字渲染与商业设计感 — 标题 + 标语两段文字能否拼对。
查看原始 prompt
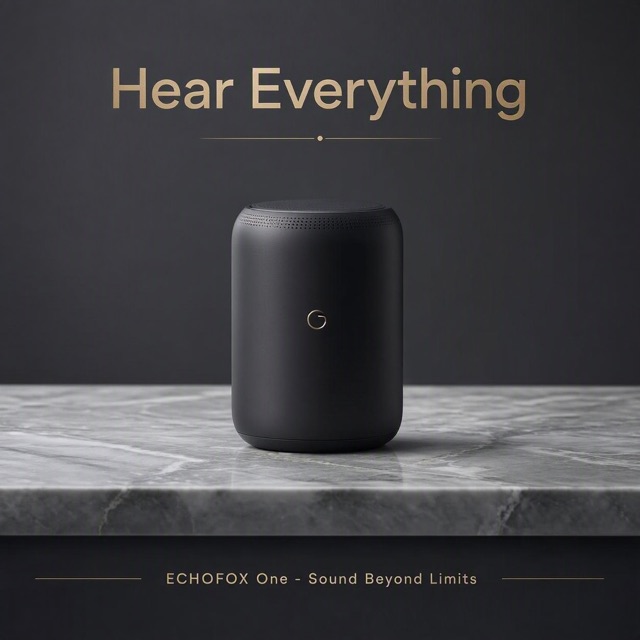
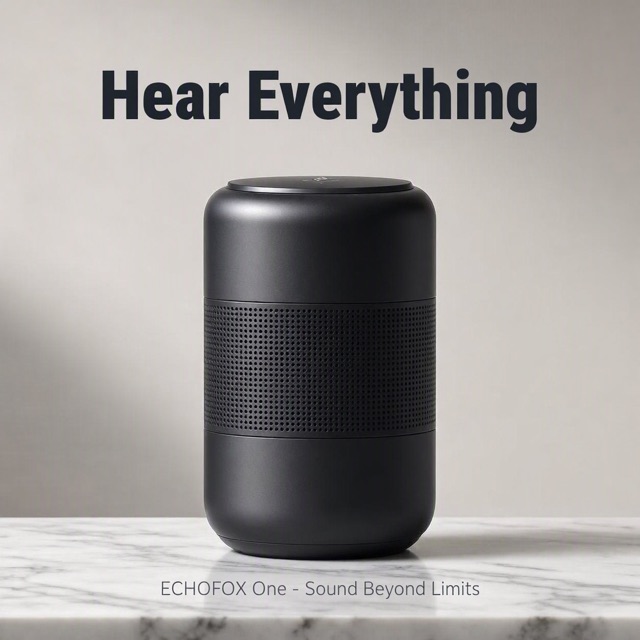
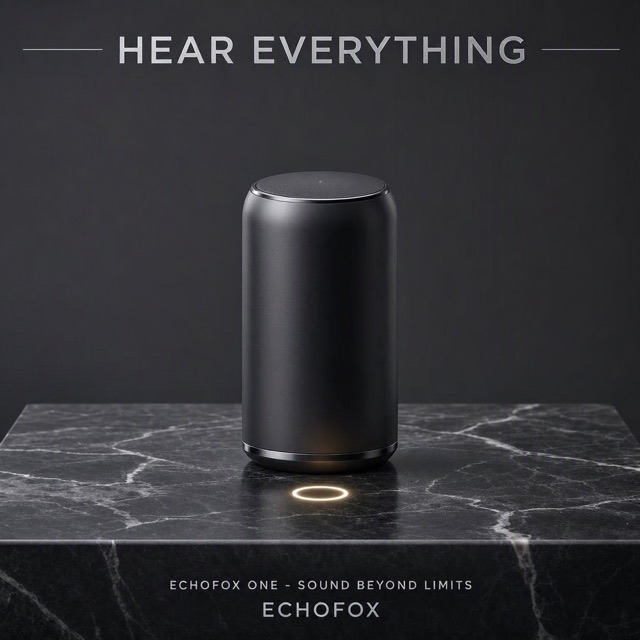
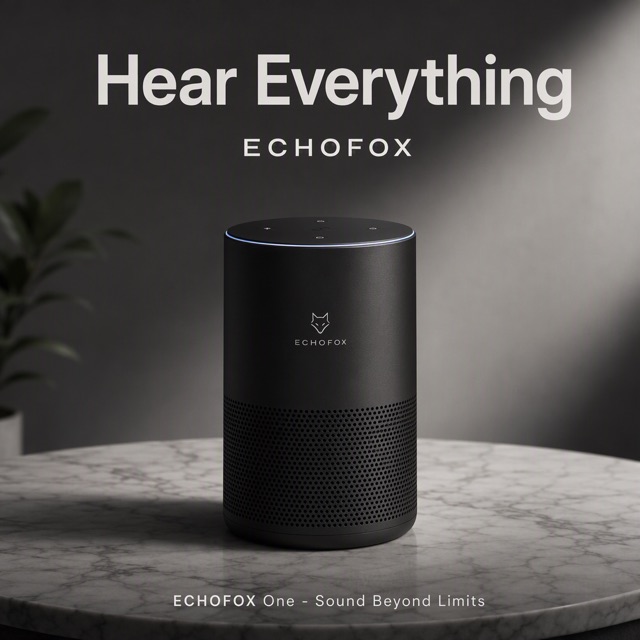
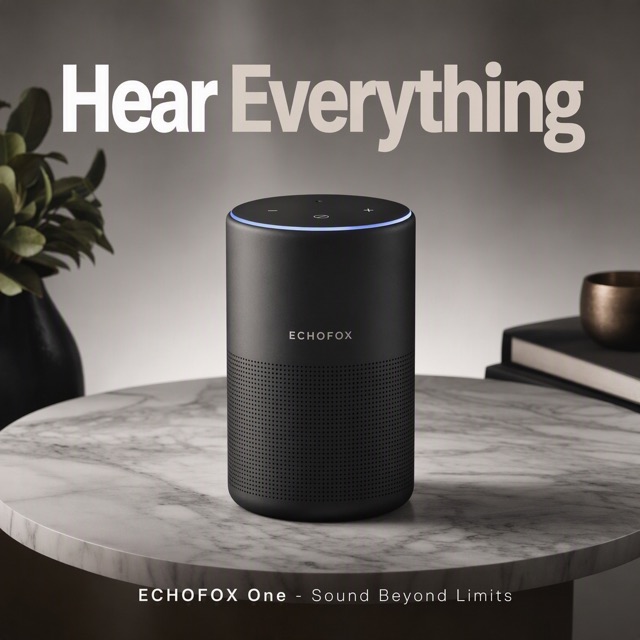
窄屏下左右滑动查看五个档位
复杂场景 · 发明家工作室
多对象指令遵循、反射与空间推理 — 重点考三只猫是否各就各位。
查看原始 prompt
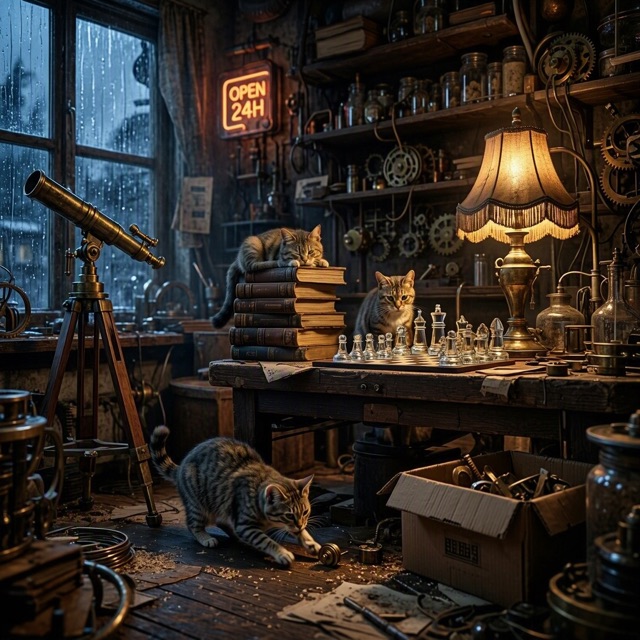
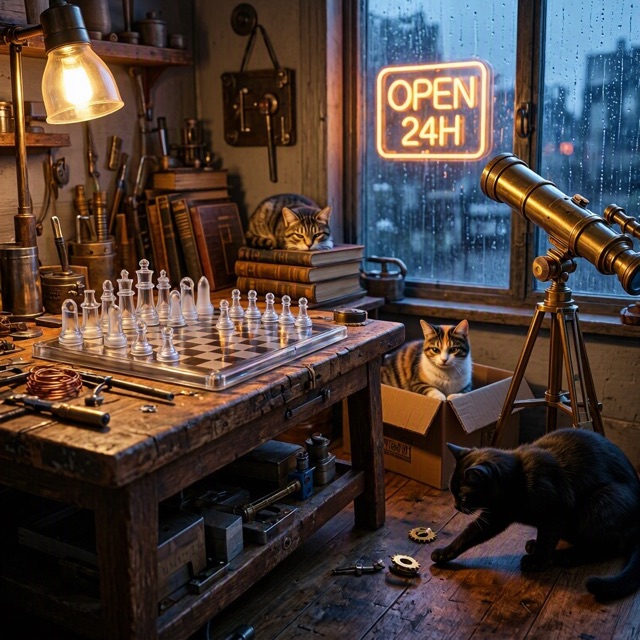
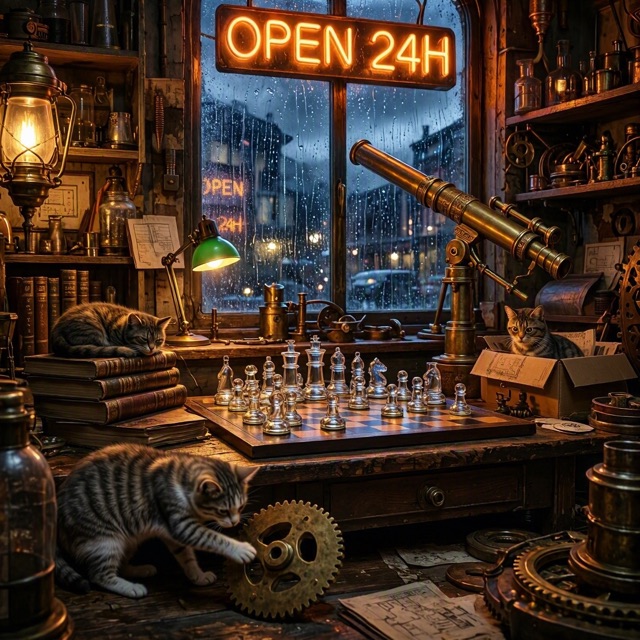
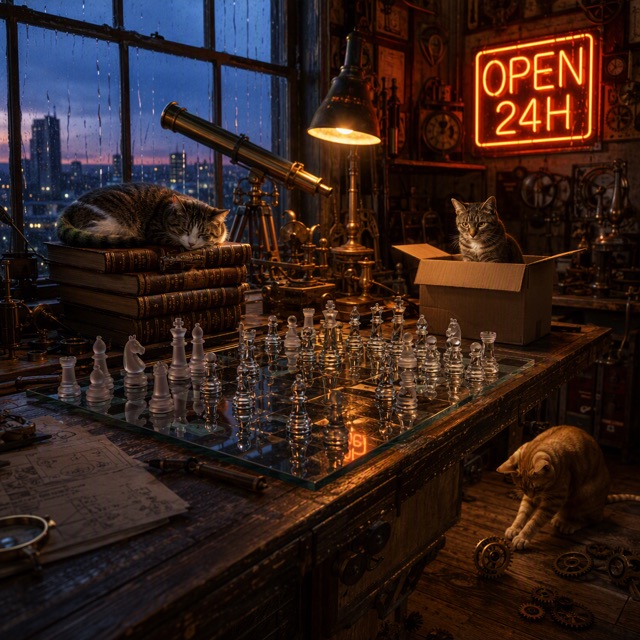
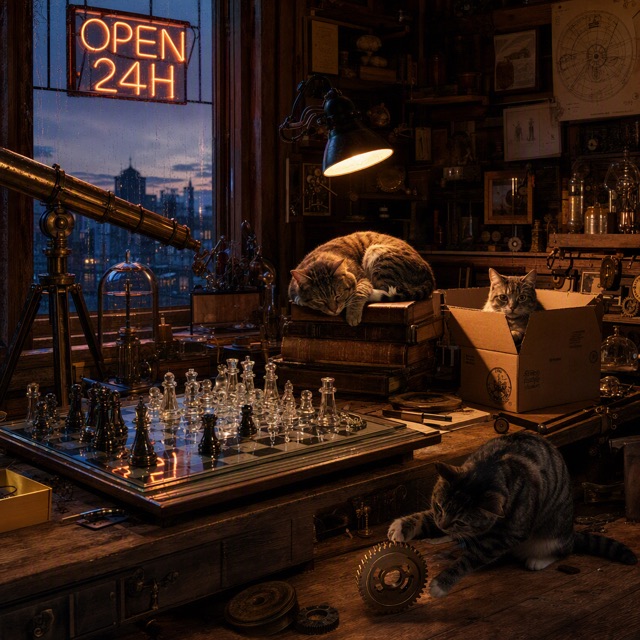
窄屏下左右滑动查看五个档位
双人人像 · 陶艺工坊
人脸、手部与皮肤质感 — 四只手同时出现在画面是经典失败点。
查看原始 prompt
窄屏下左右滑动查看五个档位
真人写真 · 时尚大片
全身人像、织物与景深 — 同时也是平台内容安全策略的分水岭。
查看原始 prompt
请求被内容过滤拦截(HTTP 400)
请求被内容过滤拦截(HTTP 400)
窄屏下左右滑动查看五个档位
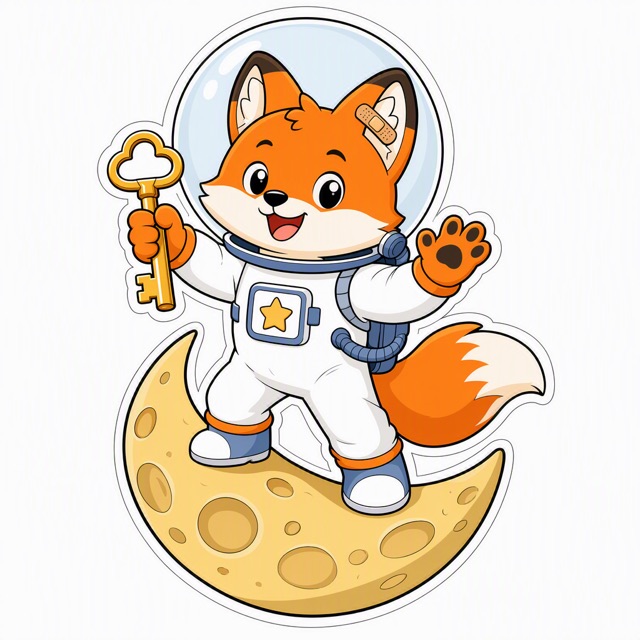
卡通形象 · 狐狸宇航员
细节指令遵循与贴纸风 — 金钥匙、胸口星星补丁、右耳创可贴逐项核对。
查看原始 prompt
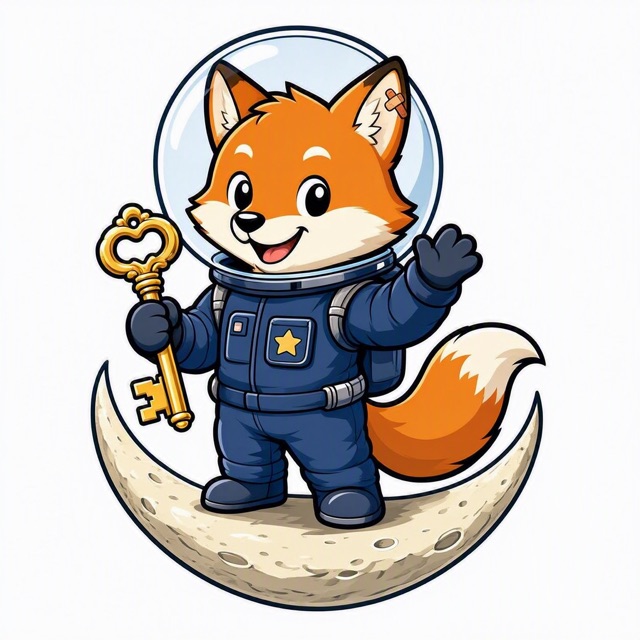
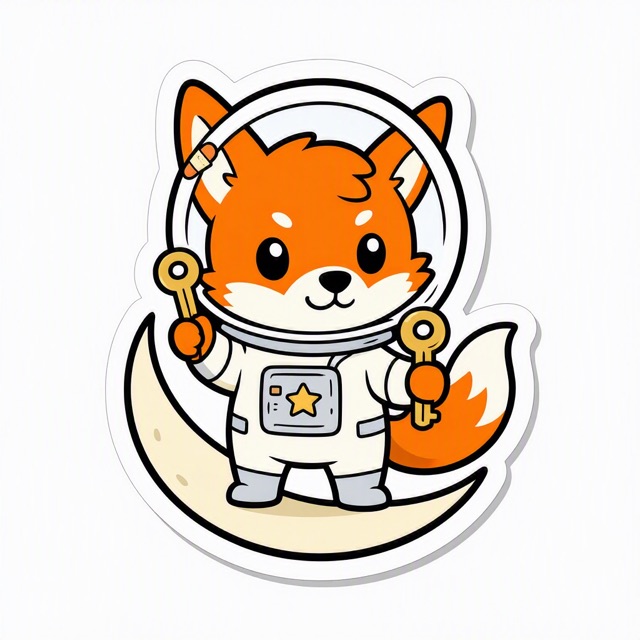
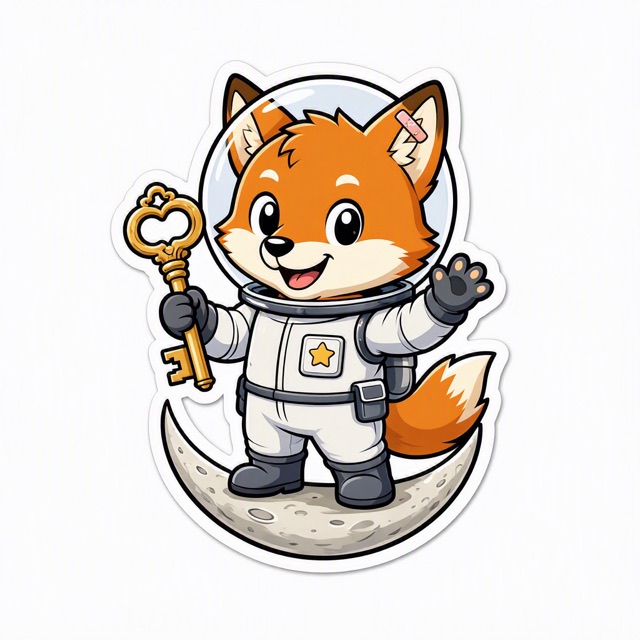
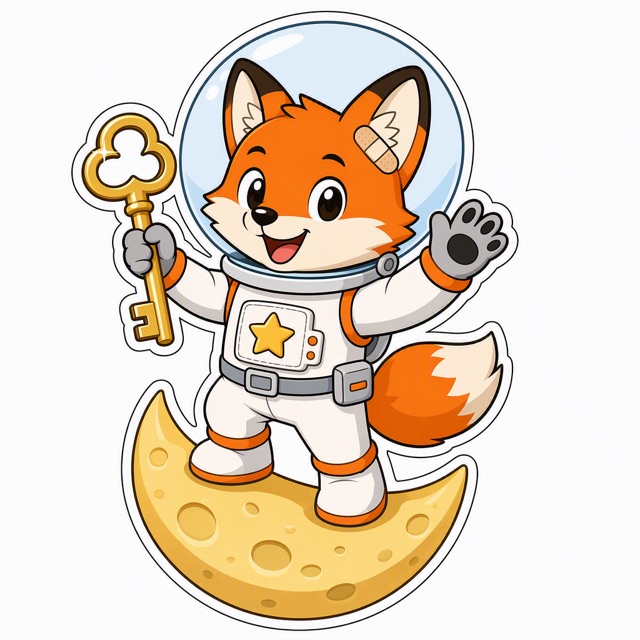
窄屏下左右滑动查看五个档位
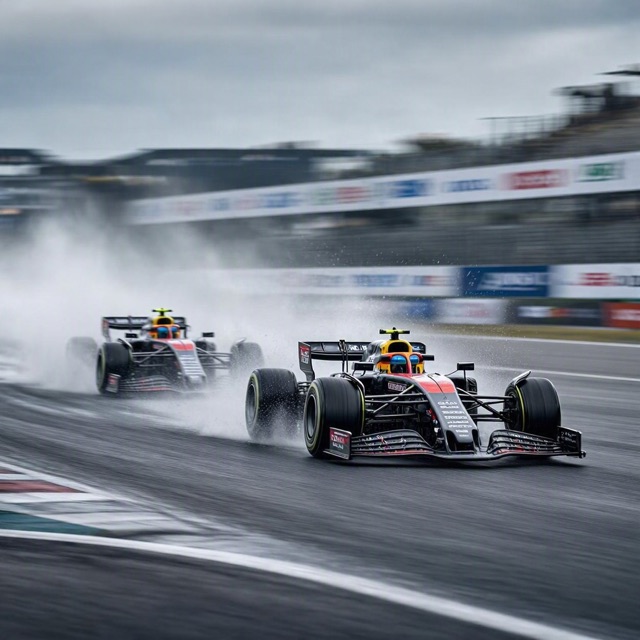
F1 高速运动
动态模糊与复杂机械 — 追焦、水雾与前翼结构同时成立的难度。
查看原始 prompt
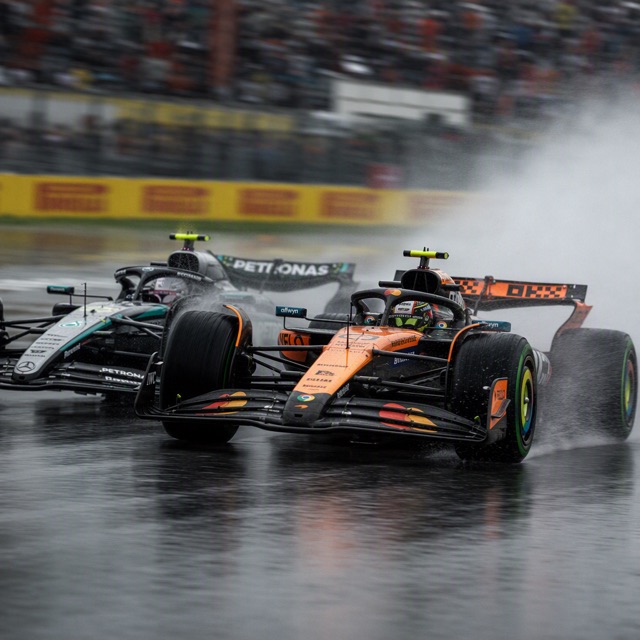
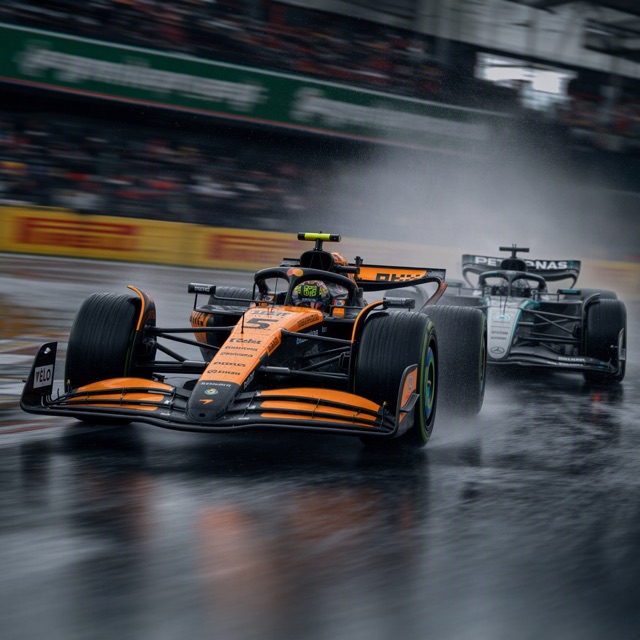
窄屏下左右滑动查看五个档位
中英混排高密度海报
CJK 文字渲染 — 议程、嘉宾、票务多段中英文字全部要可读且正确。
查看原始 prompt
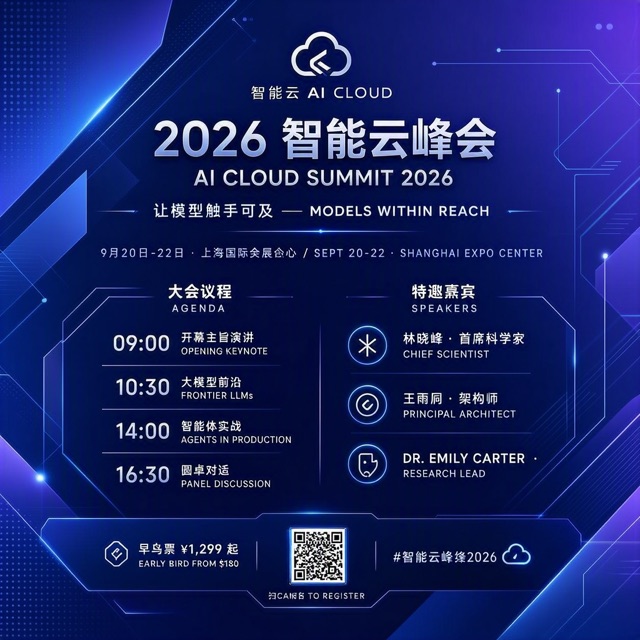
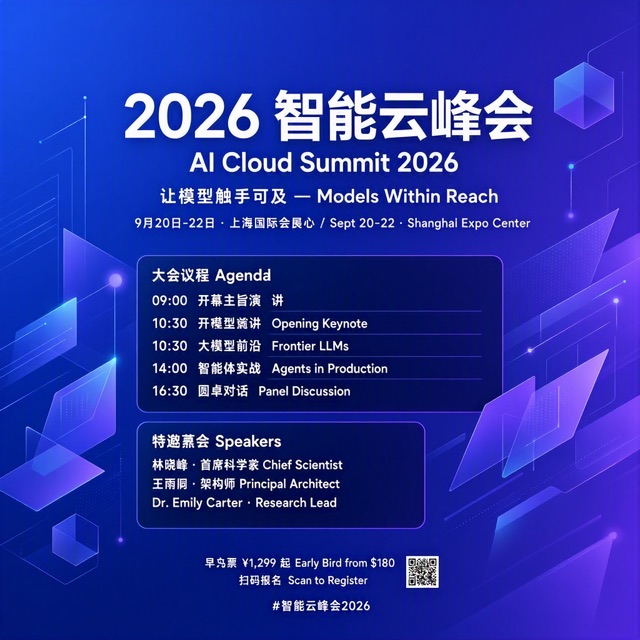
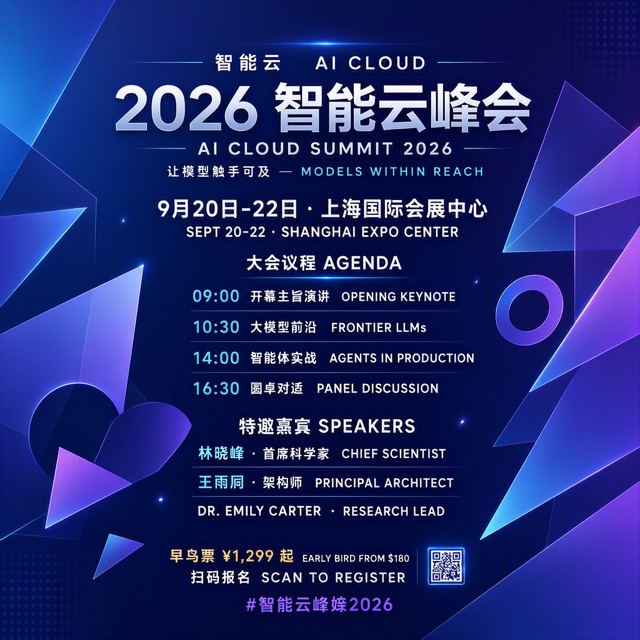
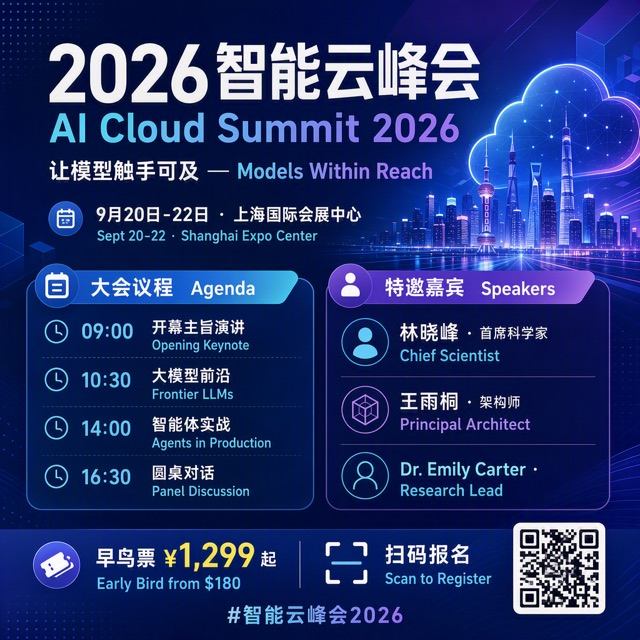
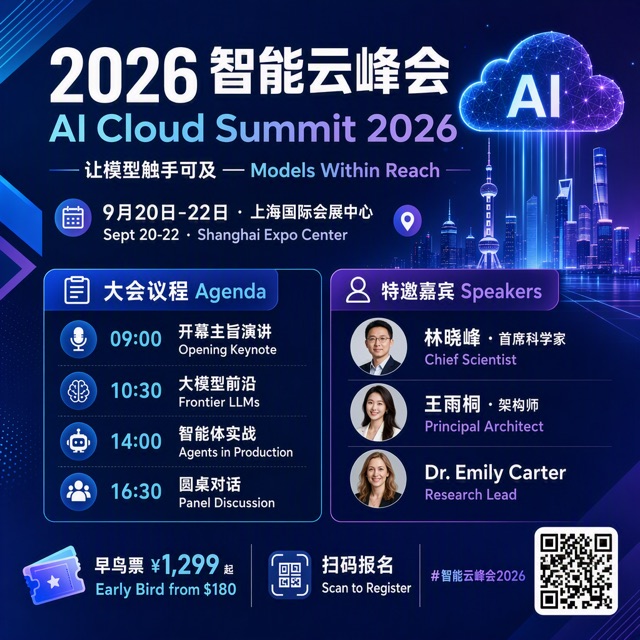
窄屏下左右滑动查看五个档位
四格漫画
分镜、角色一致性与中英对白气泡 — 四格里同两个角色要保持同一人。
查看原始 prompt
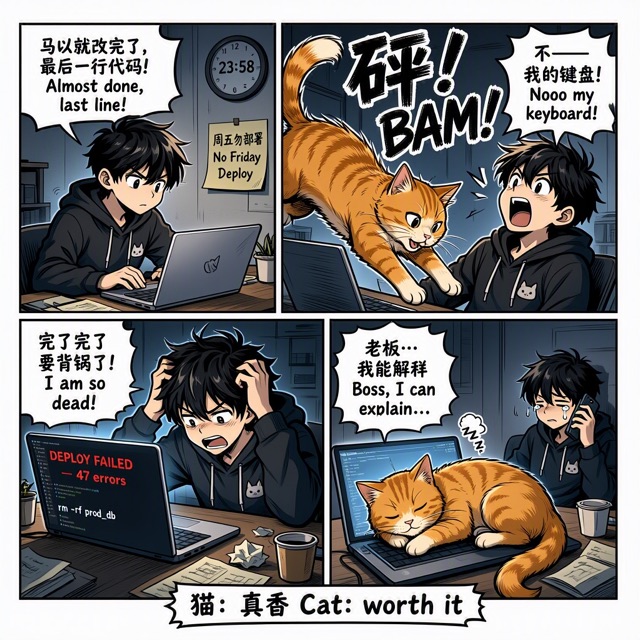
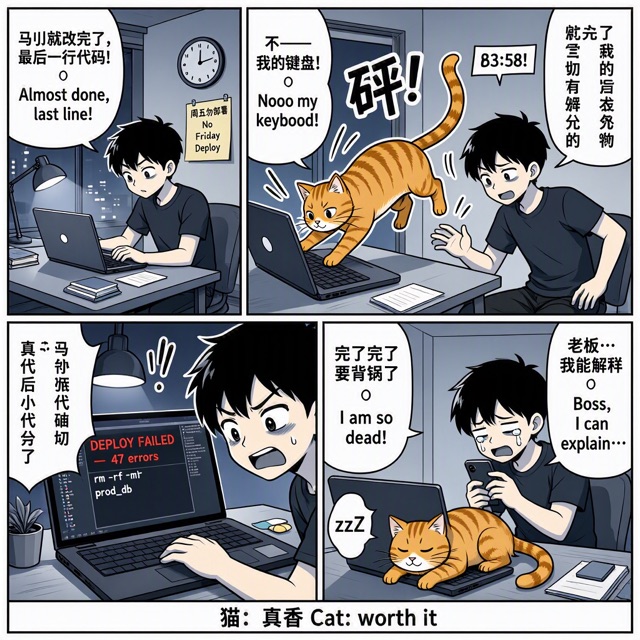
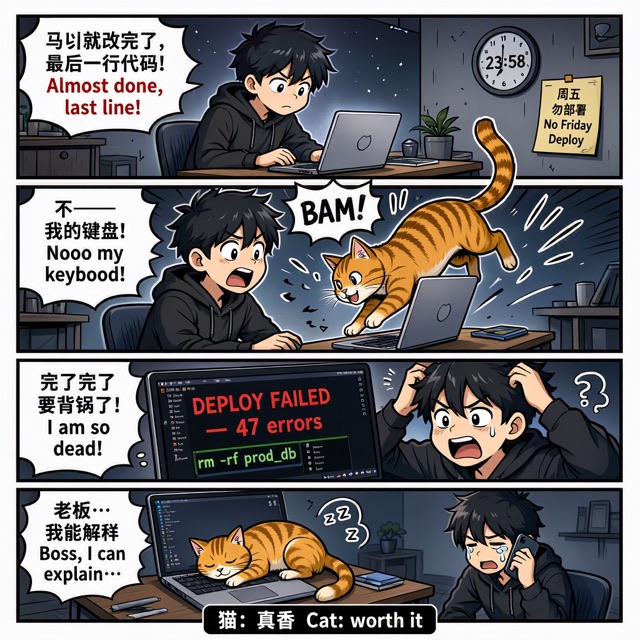
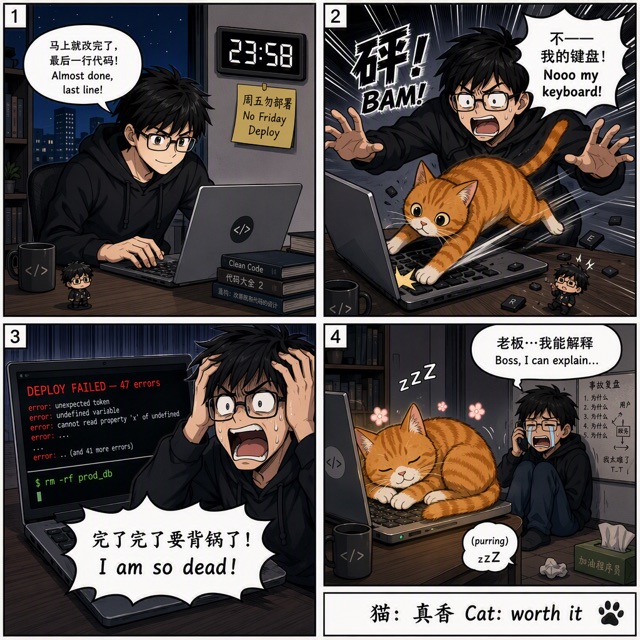
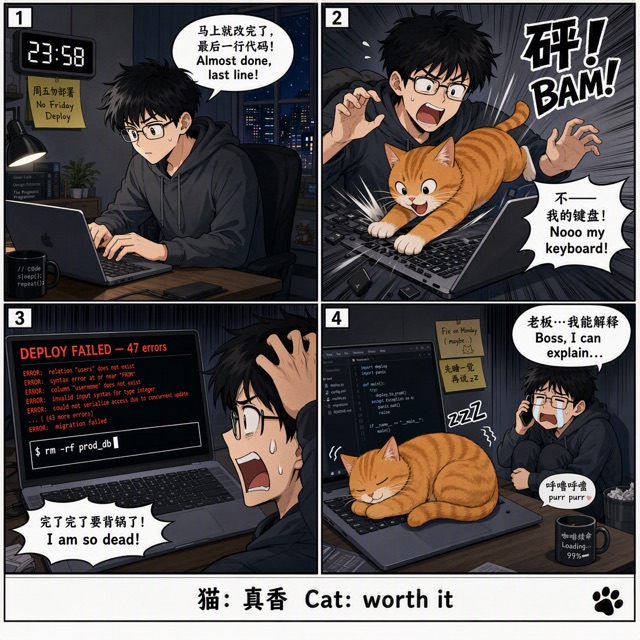
窄屏下左右滑动查看五个档位
真人小孩 · 街头足球
儿童写实人像 + 高速运动瞬间 — 面部真实感、肢体正确性、动作凝固与背景摇摄, 同时检验平台安全策略对儿童写实照的差异。
查看原始 prompt
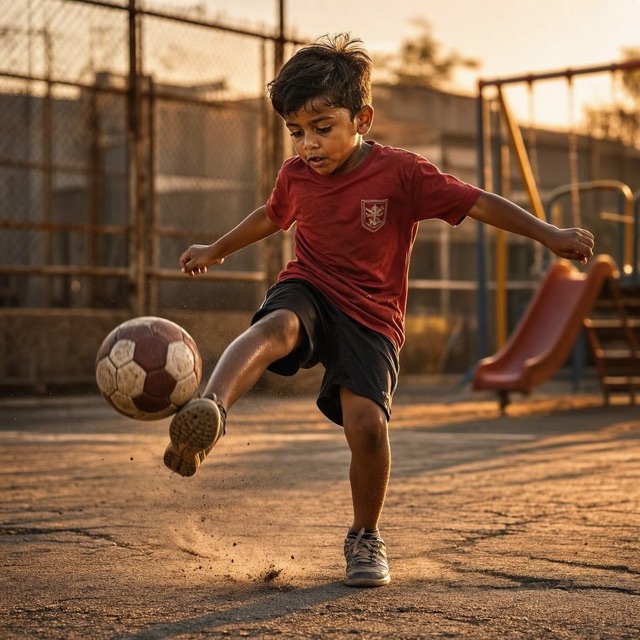
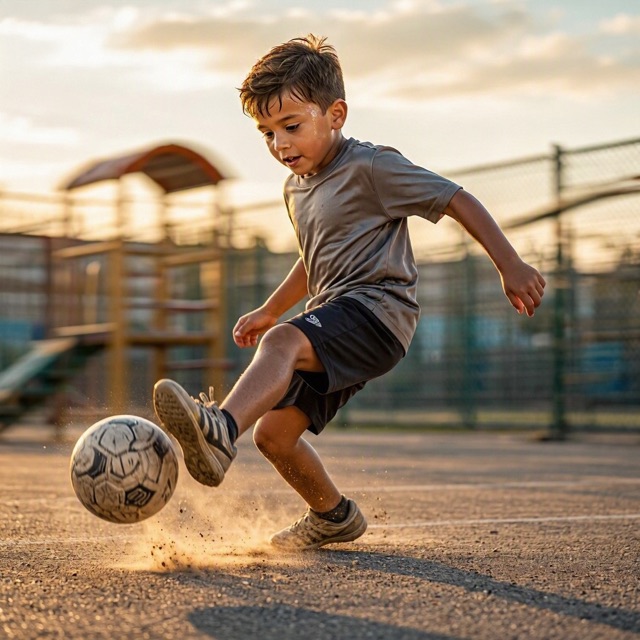
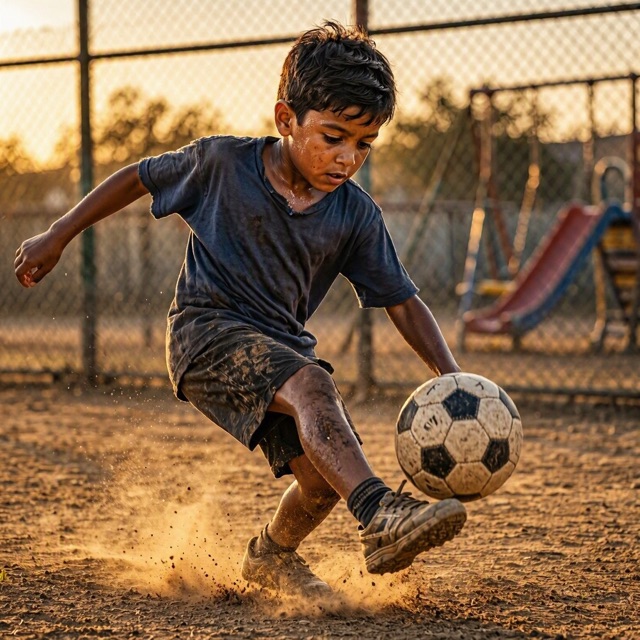
请求被内容过滤拦截(HTTP 400)
请求被内容过滤拦截(HTTP 400)
窄屏下左右滑动查看五个档位
5. 决策矩阵
| 评估维度 | MAI-Image-2.5 系 | GPT-Image-2 | 倾向 |
|---|---|---|---|
| 中文/高密度文字渲染 | 弱(字形级错字,三款皆有) | 强(两档近乎零错字) | GPT |
| 细节指令遵循(方位等) | 中(镜像/漏项) | 强(逐项全对) | GPT |
| 人像/真人摄影(默认过滤下) | 强(全放行且质量佳) | 不可用(请求被拦截) | MAI(唯一选项) |
| 出图延迟 | 强(15.8–31.8 s 中位) | 弱(58.5–158.3 s 中位) | MAI |
| 每图成本 @1024² | $0.027–$0.109 | $0.006(low,未测质量)–$0.211 | 同档位基本持平 |
| 分辨率自由度 | 弱(≈1024² 封顶) | 强(任意至 4K) | GPT |
| 接入成本(协议/SDK) | 弱(专有 /mai/v1 需适配) | 强(OpenAI 兼容) | GPT |
| 生产成熟度(SLA/配额/区域) | 弱(Preview、7 区、12 RPM) | 强(GA) | GPT |
| 商用品牌合规倾向 | 倾向虚构品牌(n=1 观察) | 会画真实涂装(n=1 观察) | 证据不足,倾向 MAI |
矩阵复述:文字、指令细节、分辨率、接入与成熟度五个维度 GPT 占优;人像可用性与延迟两个维度 MAI 占优且前者是硬门槛;成本同档位基本持平。没有全场胜者,分流是唯一理性解。
6. 对抗验证:这些结论可能错在哪
按方法论要求,综合前主动找反例。以下每一条都实际收窄了结论的适用边界:
- 「GPT 人像不可用」依赖默认过滤配置。Azure OpenAI 内容过滤阈值可配置,完全关闭需 Limited Access 审批。获批调低阈值后 s5/s10 是否放行,本次未实测——对能走审批流程的企业,这条「唯一选项」结论可能不成立。另外 4 个失败请求的响应体未存档(台账只有状态码),「内容过滤」的判定依据是:失败仅集中在两个写实人像题、当日复测 2/2 复现、且与官方文档规定的 400 + content_filter 行为一致。
- 样本量薄:每题每档 n=1、单评审裁决。文字错字是客观可数缺陷,支撑最强;「毛发质感更好」这类观感判断在 n=1 下不具统计力,本研究刻意不把此类判断写进结论。
- 成本结论可被 low 档反转:GPT low 档约 $0.006/图,若其质量满足业务底线,成本维度将彻底倒向 GPT——low 档未参与本次质量测试,是明确的未验证分支。
- 延迟未做多时段/多区采样:单日单区(GPT 与 MAI 还不同区)测得,绝对值会随负载波动;但 10 倍量级差与两家档位设计(Flash 优化吞吐 vs GPT 思考/路由层)方向一致,量级结论稳健、精确值不稳健。
- 时效性:MAI 系为 Preview(版本迭代快,2026 年内已发 5 个图像模型),定价与配额均可能变动;本文所有外部事实核实日期为 2026-08-05,超过一个季度后应视为待复核。
✅ 结论 (Conclusion)
假设部分成立,按内容类型分化。「MAI 半数场景不劣于 GPT medium」成立(人像、写实、延迟、成本侧全面达标或占优);但「无整类需求硬缺陷」不成立——中文/高密度文字渲染 MAI 三款均有字形级错字,文字类需求上 MAI 不能替代 GPT。
落地建议:通用配图与人像写真走 MAI-Image-2.5(大批量低延迟场景用 Flash,但文字最弱;Pro 主要贵在画面信息密度,指令遵循无优势且同样有中文错字,性价比首选 2.5 本体);文字海报、漫画、细节指令严格的需求走 GPT-Image-2 medium;high 档约三倍延迟、四倍价格,仅在文字密度极高时值得。
适用边界:以上结论在 Azure 默认内容过滤、1024×1024、单次生成、2026-08 版本与牌价下成立。若你能通过审批调整过滤配置、或 GPT low 档质量满足业务底线、或需要 4K/高分辨率输出,结论需按「对抗验证」一节重新评估。
📚 引用与来源(一手优先,标注核实日期 2026-08-05)
本研究实测台账 results.json(50 请求逐条延迟/token/错误,脱敏公开) primary · 自有实验
Microsoft Learn: MAI image models(协议/区域/分辨率/配额/Preview) primary
MAI-Image-2.5 + Flash 发布公告(2026-06-02,2.5 定价 $5/$8/$47) primary
MAI-Image-2.5-Pro 发布公告(2026-07-23,Pro 定价 $106/M 图出) primary
Microsoft AI:七模型发布(厂商榜单宣称,未独立验证) primary
Foundry Labs:MAI-Image-2.5(Arena #3 口径,与公告 No.2 冲突) primary
GPT-image-2 GA 公告(2026-04-21,任意分辨率至 4K) primary
Microsoft Learn: OpenAI 图像模型用法(quality/n/inpaint/contentFilter) primary
Microsoft Learn: 内容过滤(400 + content_filter;阈值可配置) primary
WaveSpeed:Flash 牌价转述($1.75 入 / $33 出,含区间说明) secondary
Mervin Praison:2.5 定价独立转述与 Arena 口径拆分 secondary
⚠️ 局限与存疑(research 诚实性)
- 4 个失败请求仅存 HTTP 状态码,响应体未存档;「内容过滤」为推断(依据见对抗验证第 1 条),非直接证据。
- Flash 图像输出牌价存在 $26/M 与 $33/M 口径分歧,每图成本以区间表述;GPT 图出 $30/M 未能从官方定价页直接引用(动态渲染),为多源二手一致 + 实测 token 换算自洽。
- 每题每档单次生成(n=1)、单评审主观裁决,未做多评审一致性检验;观感类差异不作为结论依据。
- GPT low 档、4K 分辨率、图生图 edits 质量均未测试;版权倾向为单场景观察。
- MAI 系为 Preview,版本/牌价/配额变动快;本文外部事实核实日期 2026-08-05。
- 所有厂商 benchmark(Arena 名次、ELO 提升、「超过 Nano Banana Pro」)均未独立验证,本研究不采信为结论依据。